 A Google oficializou o lançamento dos novos modelos Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking, introduzindo capacidades de raciocínio avançado em tempo quase real e processamento simultâneo de voz e pensamento. A principal inovação reside na capacidade de executar ferramentas e chamadas de API em segundo plano enquanto a conversação prossegue, eliminando pausas durante a interação.
Conversas fluídas sem interrupções
Uma das grandes vantagens desta nova geração de modelos é a capacidade de realizar pesquisas na web e executar tarefas complexas em segundo plano sem interromper o diálogo com o utilizador. Durante o processo de raciocínio mais aprofundado, os modelos conseguem emitir pistas verbais naturais, como “Deixa-me verificar isso…”, mantendo a fluidez do diálogo.
Além disso, os modelos incluem suporte para deteção automática e alternância entre 97 idiomas a meio de uma conversa, ancoragem visual em tempo quase real e uma integração otimizada com sistemas de voz. Toda a produção de áudio gerada pelos modelos integra a tecnologia de marca de água invisível SynthID, permitindo identificar conteúdos criados por IA e combater a desinformação.
Disponibilidade e resultados nos testes de desempenho
O modelo Gemini 3.8 Live já se encontra disponível através da API do Gemini, no Google AI Studio, em pré-visualização privada empresarial no Gemini Enterprise e na Pesquisa em Direto. Por sua vez, a versão Gemini 3.8 Live Extended Thinking está acessível na API, no Google AI Studio, em pré-visualização empresarial e para subscritores das aplicações do Google Workspace (Docs, Gmail e Keep), além do serviço Gemini Live.
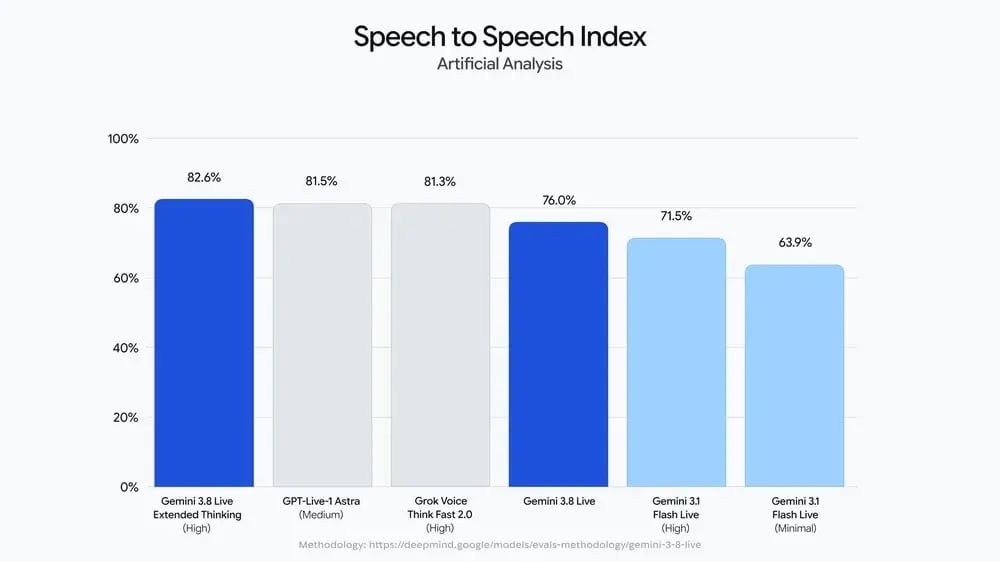
Nos testes comparativos da indústria, o Gemini 3.8 Live alcançou o segundo lugar no Speech Agent Arena. Já a variante Extended Thinking obteve uma pontuação de 82,6 no Speech to Speech Quality Index da Artificial Analysis, 68,6% no teste T-Voice, 35,1% no benchmark bancário T-Voice da Sierra e 97,7% no Big Bench Audio. Os programadores podem também integrar estes modelos através de plataformas parceiras como Agora, LiveKit, Vercel, Pipecat, Fishjam e Vision Agents.
(TT)